Få den AI-utviklede appen sjekket

AI-utviklet Få appen sjekket

Har du bygget en app med Lovable, ChatGPT/Codex, Claude Code, Cursor eller Vibe Coding?
Vi sjekker kodekvalitet, arkitektur, sikkerhet og ytelse og gir deg en klar vurdering av om du bør fortsette å bygge, lansere eller forbedre.

  • Kort rapport om 48 timer
  • uavhengig evaluert
  • verifisert av ekte utviklere

Hvem kan Sjekk AI-generert kode?

AI-generert kode gjennomgås av et uavhengig programvarebyrå med erfaring innen arkitektur, sikkerhet og drift. Vi kontrollerer autentisering, autorisasjon, databasetilgang, hemmeligheter, validering av inndata, avhengigheter, testing, utrulling og vedlikeholdbarhet. Målet er å gi deg en tydelig vurdering av om du bør fortsette utviklingen, lansere eller gjøre forbedringer. CodeGuides gjennomgår apper laget med Lovable, Claude Code, ChatGPT/Codex, Cursor og andre verktøy og gir deg en prioritert handlingsplan.

Sjekke eller sette i produksjon? En gjennomgang identifiserer risikoer og tiltak. Utbedring, utrulling og drift er separate tjenester: Gjør AI-prototypen klar for produksjon. For en formell, uavhengig vurdering se Programvarerevisjon.

Hva ligger bak søk som «AI app review Reddit» eller «ChatGPT-appgjennomgang“?

Søk med ord som Reddit, forum, anmeldelse eller erfaringer handler som regel ikke om enda en salgsside, men om reell risiko. Team vil vite om en app laget med Lovable, Claude Code, ChatGPT/Codex eller Cursor er trygg nok for faktiske brukere. Et godt svar beskriver vanlige svakheter, forklarer vurderingskriteriene og viser når en uavhengig gjennomgang er nyttig. Det er nettopp det denne siden handler om.

Welche Fragen stecken dahinter?

Typiske søk er «Lovable app security», «ChatGPT app review», «Cursor app production ready» eller «AI generated code audit». Spørsmålet er nesten alltid: Kan jeg stole på koden før kunder, investorer eller interne brukere får tilgang?

Hvorfor ikke en egen Reddit-landingsside?

En kunstig side bare for Reddit ville virket innholdsfattig og lite troverdig. Bedre er et reelt, etterprøvbart svar på spørsmål brukerne ellers ville stilt i forum: sikkerhet, autentisering, database, tester, utrulling og drift.

Hvorfor AI-generert kode trenger en uavhengig gjennomgang

Lovable, Claude Code, ChatGPT/Codex, Cursor, Copilot og andre AI-assistenter kan skrive fungerende kode, men tar sjelden hensyn til sikkerhet, arkitektur og drift. Derfor er en uavhengig kodegjennomgang nødvendig.

Sårbarheter på grunn av manglende kontekst

AI genererer kode som passer til instruksjonen, ikke til den overordnede arkitekturen. Typiske konsekvenser er ubeskyttede endepunkter, SQL-injeksjon og usikker håndtering av hemmeligheter.

  • OWASP-sårbarheter i generert kode
  • Hardkodet påloggingsinformasjon og API-nøkler
  • Manglende autentisering og autorisasjon

Arkitektur uten framsyn

AI optimaliserer lokalt ut fra den gjeldende instruksjonen. Det fører systematisk til mangelfulle overordnede arkitekturvalg, utfordringer med skalerbarhet og teknisk gjeld.

  • Inkonsistent databasestruktur og API-design
  • Kopier-lim inn redundans i stedet for abstraksjon
  • Uskalerbare mønstre under belastning

Drift og kvalitet mangler nesten alltid

Ingen overvåking, ingen testing, ingen CI/CD: AI-genererte apper kjører ofte uten tilstrekkelig innsikt. Feil blir gjerne først synlige i produksjon.

  • Manglende automatisert testing og testdekning
  • Ingen logging, overvåking eller varsling
  • Manuelle distribusjoner uten tilbakeføringsstrategi
Kontrollpunkter · Vurdering av en AI-app

Dette vi spesifikt sjekker for AI-utviklede apper

Vi vurderer grundig og med tydelige prioriteringer alle områdene AI-assistenter vanligvis overser.

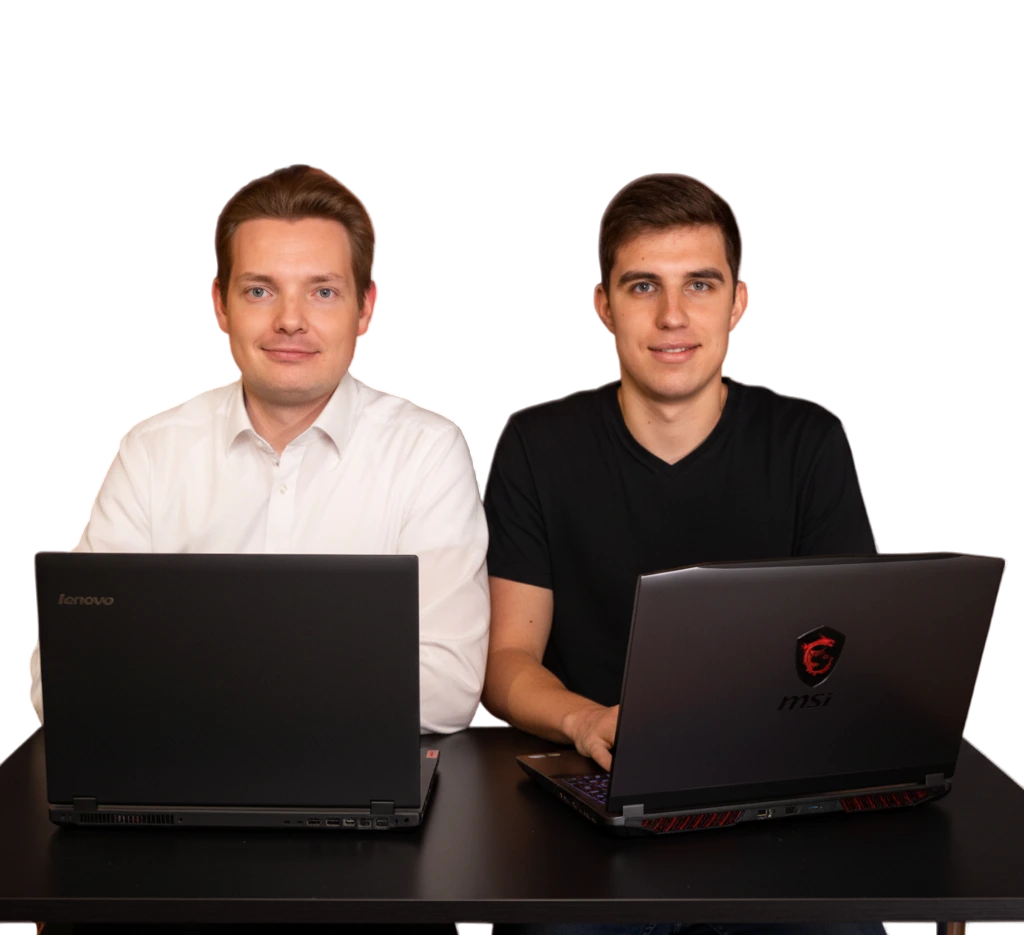
Franz Opitz og Alexander Hähnel gjennomgår en AI-app

Ved behov vurderer vi også lisensrisiko knyttet til brukte åpen kildekode-pakker, om databehandlingen oppfyller GDPR-kravene samt risiko knyttet til team og prosesser. Dette passer også godt for Due Diligence for programvare før appkjøp eller investering.

Sikkerhet og OWASP

Autentisering, autorisasjon, validering av inndata, SQL-injeksjon, XSS, CSRF, håndtering av hemmeligheter og OWASP Top 10.

Kode og arkitektur

Struktur, avhengigheter, designmønstre, redundans, teknisk gjeld og vedlikeholdbarhet i AI-generert kode.

Database og API

Konsistens i databaseskjemaet, N+1-spørringer, indekseringsstrategi, API-design, versjonering og feilhåndtering.

Drift og ytelse

Logging, overvåking, CI/CD, utrullingsstrategi, belastningstesting, hurtigbufring og robusthet.

Testing og kvalitet

Testdekning, enhets- og integrasjonstester, konfigurasjon av linter og rutiner for kodegjennomgang.

Skalerbarhet

Arkitekturvalg ved høy belastning, databasetilkoblinger, køhåndtering og klargjøring for skyen.

Lovable, Claude Code, ChatGPT/Codex & Co.: Hva vi sjekker for hvert verktøy

Hvert AI-verktøy har typiske sårbarhetsmønstre. Vi kjenner dem og undersøker målrettet hva som ofte går galt med Lovable, Claude Code, ChatGPT/Codex, Cursor og andre verktøy.

Lovable

Få Lovable-appen sjekket

Lovable genererer React-apper med Supabase-backend raskt, men det kan føre til strukturelle sikkerhetsrisikoer.

  • Supabase-nøkler i frontend-pakken
  • Sikkerhet på radnivå er ofte ikke aktivert
  • Ingen inndatavalidering på serversiden
  • Autentiseringslogikk direkte i klienten
  • Ingen hastighetsbegrensning, ingen overvåking
Claude Code

Få appen laget med Claude Code sjekket

Claude Code genererer lesbar kode, men drift, testing og arkitektur i en større sammenheng blir ofte ikke ivaretatt.

  • Manglende automatiserte tester
  • Ingen CI/CD og ingen distribusjonsoppsett
  • Arkitektur uten skaleringsbane
  • Inkonsistent feilhåndtering
  • Manglende strategi for overvåking og logging
ChatGPT/Codex

Få sjekket ChatGPT/Codex-appen

ChatGPT/Codex kan raskt lage appendringer og komplette funksjoner, men det medfører typiske risikoer knyttet til kontekstgrenser, autentisering, feilhåndtering og databasedesign.

  • Instruksjoner uten fullstendig arkitekturkontekst
  • Uensartet autentiserings- og rollelogikk
  • Databaseskjema uten indekser og begrensninger
  • Mangler CORS- og CSP-konfigurasjon
  • Ingen tydelig adskillelse mellom utviklings- og produksjonsmiljø
Cursor

Få Cursor-appen sjekket

Cursor arbeider direkte i kodeeditoren, men begrensninger i kontekstvinduet kan føre til inkonsekvenser mellom moduler.

  • Inkonsekvent feilhåndtering per fil
  • Duplisert logikk på tvers av modulgrenser
  • Hemmeligheter i .env uten validering
  • Sårbarheter i filopplastinger
  • Mangler integrasjonstester
v0.dev / Copilot

v0, Copilot og andre verktøy

v0.dev leverer UI-kode (React/Next.js), mens Copilot leverer kodeforslag. Ingen av dem tar hensyn til helheten i systemet eller sikkerheten i backend.

  • Ingen backend – bare brukergrensesnittlogikk
  • API-nøkler videreformidlet med prop drilling
  • Copilot-kode med utdaterte mønstre
  • Ingen strategi for tilstandshåndtering
  • XSS-risikoer på grunn av ukontrollert gjengivelse
Replit Agent og andre

Få sjekket andre AI-verktøy

Replit Agent, Devin, Windsurf, Gemini Code Assist og andre: Vi kjenner de typiske mønstrene for hvert verktøy og gjennomgår koden uavhengig.

  • Replit: Ingen produksjonsklar distribusjonsstabel
  • Devin: Arkitekturbeslutninger uten gjennomgang
  • Windsurf: Lignende svakheter som i Cursor
  • Uavhengig av verktøy mangler drift og testing nesten alltid
  • Vi kan også gjennomgå kodebaser med både menneskeskrevet og AI-generert kode

Vibe-kodingsapper og AI-prototyper settes trygt i produksjon

Mange team lager i dag raske prototyper og MVP-er med Lovable, Claude Code, ChatGPT/Codex eller Cursor, og vil deretter gjøre dem om til ferdige produkter. Vi undersøker hva som trygt kan videreføres, og hva må bygges om.

Hva er godt nok for produksjon?

Vi skiller tydelig mellom kode som kan brukes stabilt, og områder som må utbedres før lansering.

Prioritert handlingsplan

Du får et konkret veikart med realistiske anslag på hvor mye arbeid som kreves, og en tydelig oversikt over hva som er kritisk, viktig eller kan vente.

Valgfritt: Vi tar oss av stabiliseringen

Etter gjennomgangen kan vi gå rett i gang med å implementere sikkerhetsoppdateringer, refaktorere arkitekturen og klargjøre infrastrukturen for produksjon.

Konkrete tall i stedet for vage vurderinger

Vår gjennomgang av AI-generert kode gir realistiske tidsanslag, strukturerte kontrollpunkter og konkrete anbefalinger.

48 t
Kort rapport mulig

Topprisikoer og kritiske sårbarheter i AI-generert kode.

5–10 dager
Full rapport

Grundig analyse av arkitektur, sikkerhet og drift, med en prioritert handlingsplan.

6 nivåer
Sikkerhet frem til operasjon

Vi undersøker alle områdene AI-assistenter systematisk overser.

NDA
Konfidensielt og uavhengig

Vi jobber konfidensielt, med NDA på forespørsel. Resultatene blir med deg.

CodeGuides-teamet gjør kodegjennomgang

Slik foregår et Gjennomgang av AI-apper fra oss

Lite koordinering, grundig innsikt. Vi forstyrrer ikke driften din og leverer konkrete resultater innen tydelig definerte tidsrammer.

Hvert trinn har tydelige leveranser og fremdrift du kan følge. Du slipper å lure på hva vi gjør.

Dag 1

Kickoff, målbilde og tilnærminger

Vi avklarer mål, teknologistakk og brukskontekst, og sørger for tilgang til kodebasen og dokumentasjon av infrastrukturen.

Omfang Mål Tilganger
Dag 2–5

Analyse, sikkerhetssjekk og kodegjennomgang

Strukturert testing av kode, arkitektur, sikkerhet, database, API, tester og operasjoner, spesielt for sårbarheter som er typiske for AI.

Kode Sikkerhet Arkitektur
Dag 5–7

Resultater og handlingsplan

Prioriterte funn, risikovurdering, anslag på arbeidsmengde og anbefalinger presentert i en workshop eller rapport.

Priorisering Tiltak Valg av plattform
Valgfritt

Stabilisering og videreutvikling

På forespørsel tar vi oss av implementeringen: sikkerhetsrettinger, refaktorering av arkitekturen, oppsett av tester og CI/CD.

Feilrettinger Stabilisering Veikart

Hva du får som resultat

Tydelige, konkrete resultater som gjør det enklere å avgjøre om og hvordan appen bør videreutvikles.

Kort rapport (48 timer)

En rask oversikt når du må ta en beslutning raskt, eller som en første realitetssjekk før lansering.

  • Sammendrag
  • Kritiske sikkerhetsrisikoer med innvirkning
  • Topp 3 tiltak umiddelbart
Full rapport

Grundig analyse med fullstendig risikovurdering, prioriteringer og en konkret handlingsplan.

  • Vurdering av arkitektur og kode
  • Gjennomgang av sikkerhet og ytelse
  • Prioritert handlingsplan med innsats
Workshop og implementering

Felles gjennomgang med teamet eller ledelsen, som enkelt kan omsettes til en plan for gjennomføring.

  • Resultatworkshop med spørsmål og svar
  • PoC for kritiske emner
  • Valgfrie stabiliseringssprinter

De første, generelle rapportene koster vanligvis 1000 og 2500 €. Den nøyaktige kostnaden avhenger av kompleksiteten og hvor grundig rapporten skal være. Vi avklarer rammen i den innledende samtalen.

For hvem er AI-appvurderingen egnet?

Hvis du vil bruke en app utviklet med AI i produksjon eller videreutvikle den, trenger du en tydelig oversikt over de faktiske risikoene.

Guter Fit
  • Appen er utviklet med Lovable, Claude Code, ChatGPT/Codex, Cursor, Copilot eller lignende verktøy
  • Du vil sette en app laget med vibe coding eller en AI-prototype i produksjon
  • Du planlegger å investere i en app utviklet med AI
  • Teamet ditt er bekymret for sikkerheten eller kvaliteten på den genererte koden
  • Du vil overlate appen til andre, selge den eller gjøre den tilgjengelig for eksterne brukere
  • Appen din inneholder både menneskeskrevet og AI-generert kode
Kein Fit
  • Du forventer ren bekreftelse uten teknisk kritikk
  • Ingen tilgang til repo eller infrastruktur mulig
  • Du ønsker kun å redusere kostnadene og er ikke opptatt av kvalitet
  • Ingen interesse for konkrete tiltak

Vanlige spørsmål: Få en AI-utviklet app sjekket

Hvorfor bør jeg sjekke en AI-utviklet app?

AI-generert kode inneholder ofte skjulte sikkerhetssårbarheter, mangel på feilhåndtering og dårlige arkitektoniske beslutninger som blir kostbare i drift. En uavhengig kodegjennomgang gir klarhet før du investerer eller går live.

Hva er Vibe Coding og hva er risikoen?

Vibe-koding er praksisen med å utvikle en app nesten utelukkende gjennom spørsmål til AI-assistenter som Cursor, Copilot eller ChatGPT. Resultatet kan fungere, men kommer ofte med kritiske risikoer: manglende tester, SQL-injeksjon, ubeskyttede API-endepunkter og uskalerbar arkitektur.

Hva sjekker du for en AI-utviklet app?

Vi gjennomgår sikkerhet (OWASP, Secrets, Auth), kodekvalitet og arkitektur, databasestruktur, API-design, feilhåndtering, testdekning, operabilitet og skalerbarhet, og leverer en prioritert handlingsplan.

Hva er forskjellen fra en vanlig kodegjennomgang?

AI-appgjennomgangen vår er spesialisert på typiske svakheter ved AI-generert kode: sikkerhetshull som skyldes manglende helhetskontekst, inkonsekvent arkitektur, overflødige kopier-og-lim-inn-løsninger og manglende grunnleggende driftsrutiner som testing, CI/CD og overvåking.

Hvor lang tid tar en AI-kodegjennomgang?

En kort rapport med de viktigste risikoene er mulig på 48 timer. En komplett rapport med arkitekturanalyse og handlingsplan tar 5-10 virkedager avhengig av omfang.

Hvilken tilgang trenger dere?

Vanligvis trenger vi tilgang til kodebasen (f.eks. GitHub eller GitLab), dokumentasjon om infrastrukturen og eventuelt tilgang til testmiljøet. Vi avtaler omfanget ved oppstart og behandler alt konfidensielt.

Hvor mye koster AI App Review?

Den nøyaktige kostnaden avhenger av kompleksiteten og ønsket nøyaktighet til rapporten. Som regel koster innledende generelle rapporter fra oss mellom €1000 og €2500. Vi vil avklare det konkrete rammeverket i en gratis foreløpig diskusjon.

Kan jeg videreutvikle appen eller få den stabilisert etterpå?

Ja. Etter gjennomgangen kan vi ta oss av stabilisering, videreutvikling eller fullstendig konvertering, inkludert veikart, sikkerhetsrettinger og implementeringssprinter.

Er anmeldelsen også egnet for en app jeg ønsker å kjøpe eller investere i?

Ja. Vår AI-appgjennomgang gir en teknisk beslutningsmal for investorer og kjøpere, med klare risikoer, kostnadsimplikasjoner og anbefalinger for evaluering.

Hvilke AI-verktøy kan du vurdere i en apprevisjon?

Vi gjennomgår apper som er utviklet med vanlige AI-verktøy, blant annet Lovable, Claude Code, ChatGPT/Codex, Cursor, GitHub Copilot, v0.dev og Replit Agent. Hvert verktøy har typiske svakheter som vi undersøker målrettet.

Kan du få sjekket en Lovable-app?

Ja. Lovable-apper bruker React med Supabase som backend. Dette kan innebære tydelige sikkerhetsrisikoer: Supabase-nøkler i frontend-pakken, manglende sikkerhet på radnivå, ingen validering på serversiden og autentiseringslogikk direkte i klienten. Vi undersøker disse svakhetene og gir dere en prioritert handlingsplan.

Kan du få sjekket en Claude Code-app?

Ja. Claude Code har også typiske hull: manglende tester, ingen CI/CD-oppsett, arkitektoniske beslutninger uten overordnet kontekst og operasjonelle grunnleggende som ikke var en del av forespørselen. Vi sjekker uavhengig og viser hva som mangler før produktiv drift.

Kan du få sjekket en ChatGPT/Codex-app?

Ja. Apper og funksjoner laget med ChatGPT/Codex utvikles raskt, men har ofte mangler fordi helhetskonteksten mangler: uensartet autentisering, svak feilhåndtering, manglende tester og uklar adskillelse mellom utviklings- og produksjonsmiljøet. Vi vurderer hva som må bygges om før appen kan settes i drift.

Sjekker du også apper som ble utviklet med flere AI-verktøy samtidig?

Ja. Mange prosjekter utvikles med en kombinasjon av verktøy, for eksempel Lovable til frontend, Claude Code til backend-logikk og Copilot til enkeltfunksjoner. Vi går gjennom hele kodebasen, uavhengig av hvilke verktøy som er brukt, og ser også etter inkonsekvenser i grensesnittene.

Hvor konfidensiell er rapporten?

Vi jobber konfidensielt og vil signere en NDA på forespørsel. Resultater og kode forblir utelukkende dine.

Har du et spørsmål som ikke er besvart her? Forklar i avtalen →

Hvorfor CodeGuides for gjennomgangen av AI-appen?

  • In-house team fra Tyskland: Du jobber med et fast tysk team: ingen frilansere, ingen outsourcingrisiko.
  • ⌨️ Eksperter på komplekse prosjekter: Du drar nytte av spesialister innen arkitektur, apputvikling, backend og QA, alt fra én enkelt kilde.
  • 💲 Kostnadskontroll og tydelig planlegging: Full åpenhet gjennom minutt-for-minutt tidsregistrering, realistiske veikart og pålitelige innsatsanslag.
Alexander Hähnel-portrett
Alexander Hähnel
Administrerende direktør, app- og programvareutvikling
Franz Opitz-portrett
Franz Opitz
Administrerende direktør, automatisering og skydistribusjon

Få AI-appen gjennomgått: Bestill en førstegangssamtale

Om CodeGuides

CodeGuides utvikler apper for forbrukere og bedrifter med hovedvekt på B2C-apper. Vårt interne team i Tyskland står for produktplanlegging, Flutter-utvikling og langsiktig drift samt skreddersydd programvare, KI-automatisering og lokal KI-infrastruktur.

CodeGuides GmbH · Königs Wusterhausen På markedet siden 2018 100+ digitale prosjekter 100 % in-house (DE) Rådgivning og implementering samlet