Laat de door AI ontwikkelde app controleren

AI ontwikkeld Laat de app controleren

Heb je een app gebouwd met Lovable, ChatGPT/Codex, Claude Code, Cursor of Vibe Coding?
We controleren de codekwaliteit, architectuur, beveiliging en prestaties en geven u een duidelijke beoordeling of u moet doorgaan met bouwen, lanceren of verbeteren.

  • Kort rapport binnen 48 uur
  • onafhankelijk geëvalueerd
  • geverifieerd door echte ontwikkelaars

Wie kan Controleer de door AI gegenereerde code?

AI-gegenereerde code wordt gecontroleerd door een onafhankelijk softwarebureau met ervaring op het gebied van architectuur, beveiliging en bedrijfsvoering. Authenticatie, autorisatie, databasetoegang, geheimen, invoervalidatie, afhankelijkheden, testen, implementatie en onderhoudbaarheid worden gecontroleerd. Het doel is om een ​​duidelijke afweging te krijgen of je door moet gaan met bouwen, lanceren of verbeteren. CodeGuides controleert apps van Lovable, Claude Code, ChatGPT/Codex, Cursor en andere tools en biedt een geprioriteerd actieplan.

Controleren of productief maken? Een audit brengt risico's en maatregelen in kaart. De daaropvolgende reparatie, implementatie en bediening is een aparte service: AI-prototype gereed maken voor productie. Voor een formele, onafhankelijke beoordeling zie Software-audit.

What is behind searches such as "AI app review Reddit" or "ChatGPT app review“?

Suchanfragen mit Zusätzen wie Reddit, Forum, Review oder Erfahrungen zeigen meist kein Interesse an einer weiteren Werbeseite, sondern an echten Risiken. Teams wollen wissen, ob eine mit Lovable, Claude Code, ChatGPT/Codex oder Cursor gebaute App sicher genug für echte Nutzer ist. Eine gute Antwort benennt typische Schwachstellen, erklärt Prüfkriterien und zeigt, wann ein unabhängiges Review sinnvoll ist. Genau darauf ist diese Seite ausgerichtet.

Welche Fragen stecken dahinter?

Typische Suchmuster sind „Lovable app security“, „ChatGPT app review“, „Cursor app production ready“ oder „AI generated code audit“. Gemeint ist fast immer: Kann ich diesem Code trauen, bevor Kunden, Investoren oder interne Nutzer darauf zugreifen?

Warum keine eigene Reddit-Landingpage?

Eine künstliche Seite nur für den Zusatz Reddit wäre dünn und nicht glaubwürdig. Besser ist eine echte, prüfbare Antwort auf die Fragen, die Nutzer sonst in Foren stellen würden: Security, Auth, Datenbank, Tests, Deployment und Betrieb.

Waarom AI-gegenereerde code heeft een onafhankelijke beoordeling nodig

Lovable, Claude Code, ChatGPT/Codex, Cursor, Copilot en andere AI-assistenten schrijven werkende code, maar nemen security, architectuur en beheer zelden volledig mee. Daarom is een onafhankelijke code review essentieel.

Kwetsbaarheden vanwege ontbrekende context

AI genereert code die past bij de prompt, niet bij de algehele architectuur. Typische gevolgen: onbeveiligde eindpunten, SQL-injectie, onveilig geheimbeheer.

  • OWASP-kwetsbaarheden in gegenereerde code
  • Hardgecodeerde inloggegevens en API-sleutels
  • Ontbrekende authenticatie en autorisatie

Architectuur zonder vooruitziende blik

KI optimaliseert lokaal voor de huidige prompt. Mondiale architectonische beslissingen, schaalbaarheid en technische schulden ontstaan ​​systematisch.

  • Inconsistente databasestructuur en API-ontwerp
  • Kopieer-plak redundantie in plaats van abstractie
  • Onschaalbare patronen onder belasting

De werking en kwaliteit ontbreken bijna altijd

Geen monitoring, geen testen, geen CI/CD: door AI gegenereerde apps werken vaak blind. Fouten worden pas zichtbaar tijdens de productieve bedrijfsvoering.

  • Gebrek aan geautomatiseerde tests en dekking
  • Geen logboekregistratie, geen monitoring, geen waarschuwingen
  • Handmatige implementaties zonder een rollback-strategie
Checkpoints · AI-app late bestelling

Wat we specifiek controleren voor door AI ontwikkelde apps

We evalueren alle gebieden die AI-assistenten doorgaans negeren met technische diepgang en duidelijke prioriteiten.

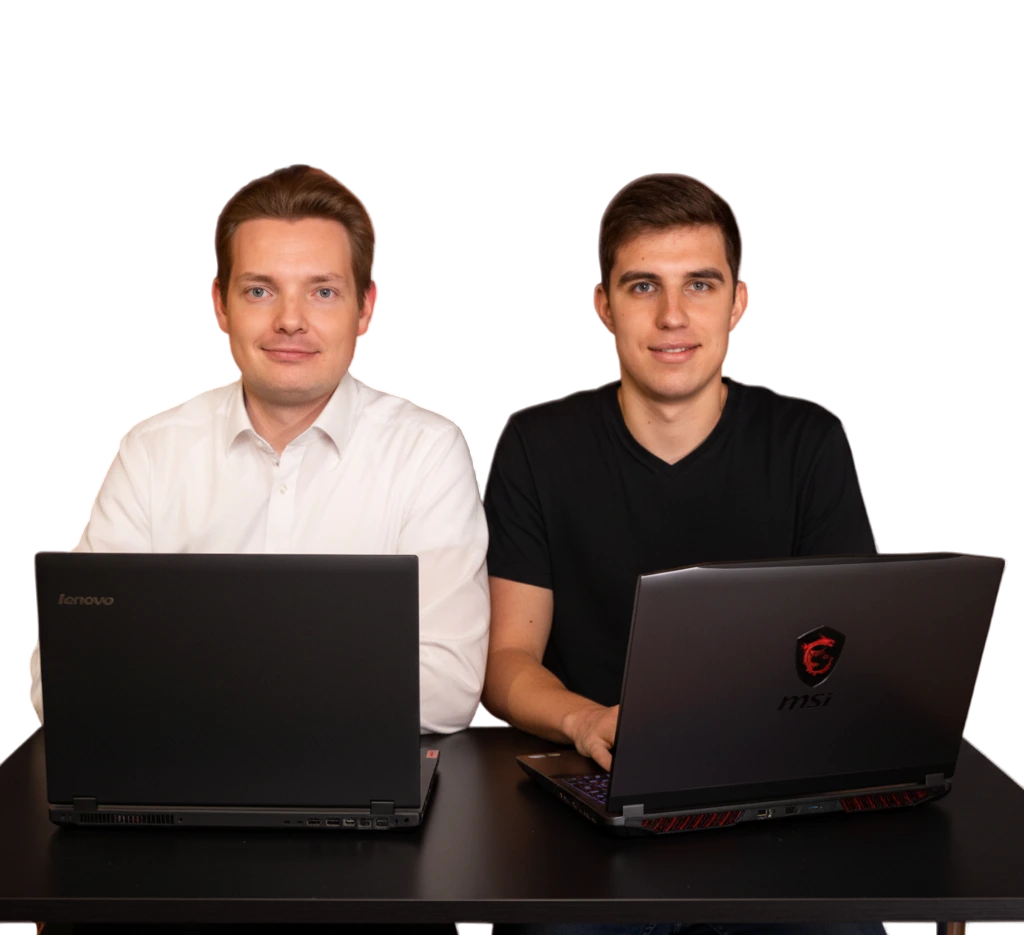
Franz Opitz en Alexander Hähnel beoordelen een AI-app

Indien nodig controleren we ook licentierisico's voor gebruikte open source-pakketten, AVG-compliance van gegevensverwerking en team- en procesrisico's. Ook ideaal voor Softwaredue diligence vóór app-aankoop of investering.

Beveiliging en OWASP

Authenticatie, autorisatie, invoervalidatie, SQL-injectie, XSS, CSRF, geheimenbeheer en OWASP Top 10.

Code en architectuur

Structuur, afhankelijkheden, ontwerppatronen, redundanties, technische schulden en onderhoudbaarheid van de door AI gegenereerde code.

Database en API

Schemaconsistentie, N+1 queries, indexstrategie, API-ontwerp, versiebeheer en foutafhandeling.

Bediening en prestaties

Logboekregistratie, monitoring, CI/CD, implementatiestrategie, belastingtests, caching en veerkracht.

Testen en kwaliteit

Testdekking, unit- en integratietests, linterconfiguratie en codebeoordelingsproces.

Schaalbaarheid

Architectonische beslissingen onder belasting, databaseverbindingen, wachtrijbeheer en gereedheid voor de cloud.

Lovable, Claude Code, ChatGPT/Codex & Co.: wat we voor elk gereedschap controleren

Elke AI-tool wordt geleverd met typische kwetsbaarheidspatronen. Wij kennen ze en kijken specifiek wat er mis gaat met Lovable, Claude Code, ChatGPT/Codex, Cursor of andere tools.

Lief

Laat Lovable App aanvinken

Lovable genereert React-apps met Supabase-backend, snel, maar met structurele beveiligingsrisico's.

  • Supabase-sleutels in de frontendbundel
  • Beveiliging op rijniveau is vaak niet geactiveerd
  • Geen invoervalidatie aan de serverzijde
  • Auth-logica rechtstreeks in de client
  • Geen snelheidsbeperking, geen monitoring
Claude-code

Laat de Claude Code-app controleren

Claude Code genereert leesbare code, maar operaties, testen en architectuur in de algemene context ontbreken doorgaans.

  • Gebrek aan geautomatiseerde tests
  • Geen CI/CD en geen implementatie-instellingen
  • Architectuur zonder schaalpad
  • Inconsistente foutafhandeling
  • Geen monitoring- en logboekstrategie
ChatGPT/Codex

Laat de ChatGPT/Codex-app controleren

ChatGPT/Codex kan snel app-aanpassingen en complete features genereren, met typische risico s rond contextgrenzen, authenticatie, foutafhandeling en databaseontwerp.

  • Prompts without vollständigen Architekturkontext
  • Inconsistente authenticatie- en rollenlogica
  • Databaseschema zonder indexen en beperkingen
  • Ontbrekende CORS- en CSP-configuratie
  • Geen duidelijke scheiding tussen development en productie
Cursor

Laat de cursor-app controleren

Cursor werkt rechtstreeks in de editor, maar de grenzen van het contextvenster leiden tot inconsistenties over de modulegrenzen heen.

  • Inconsistente foutafhandeling per bestand
  • Dupliceer logica over modulegrenzen heen
  • Geheimen in .env zonder validatie
  • Kwetsbaarheden in het uploaden van bestanden
  • Ontbrekende integratietests
v0.dev / Copiloot

v0, Copilot en andere tools

v0.dev levert UI-code (React/Next.js), Copilot-fragmenten, beide zonder naar het algehele systeem of de backend-beveiliging te kijken.

  • Geen backend, alleen UI-logica geleverd
  • API-sleutels doorgegeven als propboren
  • Copilot-fragmenten met verouderde patronen
  • Geen strategie voor statusbeheer
  • XSS-risico's als gevolg van ongecontroleerde weergave
Replit-agent en anderen

Laat andere AI-tools controleren

Replit Agent, Devin, Windsurf, Gemini Code Assist en anderen: we kennen de typische patronen van elke tool en controleren deze onafhankelijk.

  • Herhaling: geen productieklare implementatiestack
  • Devin: Architectuurbeslissingen zonder beoordeling
  • Windsurf: soortgelijke zwakke punten als Cursor
  • Tool-onafhankelijk: bediening en testen ontbreken bijna altijd
  • Gemengde codebases (mens + AI) kunnen ook worden getest

Vibe-coderingsapps en AI-prototypes veilig in productie genomen

Veel teams ontwikkelen tegenwoordig snelle prototypes en MVP's met Lovable, Claude Code, ChatGPT/Codex of Cursor, en willen deze vervolgens omzetten in echte producten. Wij kijken wat veilig kan worden overgenomen en wat moet opnieuw worden opgebouwd.

Wat is goed genoeg voor productie?

We maken duidelijk onderscheid tussen code die op een stabiele manier kan worden gebruikt en gebieden die vóór de lancering moeten worden opgeruimd.

Geprioriteerd actieplan

U ontvangt een concreet stappenplan: wat cruciaal is, wat belangrijk is, wat kan wachten, met realistische schattingen van de inspanning.

Optioneel: wij zorgen voor de stabilisatie

Na de beoordeling kunnen we meteen beginnen met de implementatie ervan: beveiligingspatches, refactoring van de architectuur en een productieklare infrastructuur.

Wis cijfers in plaats van vage beoordelingen

Onze AI-codebeoordeling biedt betrouwbare tijdsperioden, gestructureerde controlepunten en bruikbare aanbevelingen.

48 uur
Kort rapport mogelijk

Belangrijkste risico's en kritieke kwetsbaarheden in door AI gegenereerde code.

5-10 dagen
Volledig rapport

Diepe analyse met architectuur, beveiliging, operaties en geprioriteerd actieplan.

6 niveaus
Beveiliging tot operatie

We controleren alle gebieden die AI-assistenten systematisch negeren.

NDA
Vertrouwelijk en onafhankelijk

Wij werken vertrouwelijk, op verzoek met een geheimhoudingsverklaring. Resultaten blijven bij je.

CodeGuides-team voert codebeoordeling uit

Zo werkt het AI-appbeoordeling van ons

Minimale coördinatie-inspanning, maximaal inzicht. Wij verstoren uw bedrijfsvoering niet en leveren bruikbare resultaten binnen duidelijke tijdsbestekken.

Elke stap heeft gedefinieerde resultaten en traceerbare voortgang. Geen giswerk over wat we doen.

Dag 1

Aftrap, doelimago en aanpak

We verduidelijken doelen, tech-stack, gebruikscontext en verkrijgen repo-toegang en infrastructuurdocumentatie.

Reikwijdte Doelen Toegangen
Dag 2-5

Analyse, veiligheidscontrole en codebeoordeling

Gestructureerd testen van code, architectuur, beveiliging, database, API, tests en bewerkingen, vooral voor kwetsbaarheden die typisch zijn voor AI.

Code Beveiliging Architectuur
Dag 5-7

Resultaten en actieplan

Geprioriteerde bevindingen, risicobeoordeling, inspanningsschatting en aanbevelingen, gepresenteerd in een workshop of als rapport.

Prioriteit Maatregelen Besluit
Optioneel

Stabilisatie en verdere ontwikkeling

Wij verzorgen op verzoek de implementatie: beveiligingsoplossingen, architectuurrefactoring, testopstelling, CI/CD-installatie.

Opgeloste problemen Stabilisatie Routekaart

Wat u als resultaat krijgt

Duidelijke, bruikbare resultaten zodat u een weloverwogen beslissing kunt nemen of en hoe u de app verder wilt ontwikkelen.

Kort rapport (48 uur)

Snel overzicht voor urgente beslissingen of als eerste reality check vóór de lancering.

  • Samenvatting
  • Kritieke veiligheidsrisico's met impact
  • Top 3 maatregelen onmiddellijk
Volledig rapport

Diepgaande analyse met volledige risicobeoordeling, prioritering en concreet actieplan.

  • Architectuur- en code-evaluatie
  • Beoordeling van beveiliging en prestaties
  • Geprioriteerd actieplan met inspanning
Workshop & implementatie

Gezamenlijke evaluatie met team of management, kan direct worden overgedragen naar de implementatieplanning.

  • Resultatenworkshop met vraag en antwoord
  • PoC voor kritieke onderwerpen
  • Optionele stabilisatiesprints

Initiële algemene rapporten kosten meestal tussen de 1.000 en 2.500 €. De exacte kosten zijn afhankelijk van de complexiteit en gewenste diepgang. In het voorgesprek zullen we het kader verduidelijken.

Voor wie is de AI-app-recensie geschikt?

Als u een door AI ontwikkelde app productief wilt gebruiken of verder wilt ontwikkelen, heeft u duidelijkheid nodig over de daadwerkelijke risico's.

Goede pasvorm
  • De app is ontwikkeld met Lovable, Claude Code, ChatGPT/Codex, Cursor, Copilot of vergelijkbare tools
  • Je wilt een vibe-coderingsapp of een AI-prototype in productie nemen
  • U bent van plan te investeren in een door AI ontwikkelde app
  • Uw team heeft beveiligingsproblemen of twijfels over de kwaliteit van de gegenereerde code
  • U wilt de app overdragen, verkopen of laten gebruiken door externe gebruikers
  • Uw app combineert door mensen geschreven en door AI gegenereerde code
Niet geschikt
  • Je verwacht pure bevestiging zonder technische kritiek
  • Geen toegang tot repository of infrastructuur mogelijk
  • Pure kostenoptimalisatie zonder interesse in kwaliteit
  • Geen interesse in concrete maatregelen

Veelgestelde vragen: laat de door AI ontwikkelde app controleren

Waarom moet ik een door AI ontwikkelde app laten controleren?

Door AI gegenereerde code bevat vaak verborgen beveiligingsproblemen, een gebrek aan foutafhandeling en slechte architectonische beslissingen die kostbaar worden in het gebruik. Een onafhankelijke code review zorgt voor duidelijkheid voordat u investeert of live gaat.

Wat is Vibe Coding en wat zijn de risico's?

Vibe-codering is de praktijk waarbij een app bijna volledig wordt ontwikkeld via aanwijzingen aan AI-assistenten zoals Cursor, Copilot of ChatGPT. Het resultaat kan werken, maar brengt vaak kritieke risico's met zich mee: ontbrekende tests, SQL-injectie, onbeschermde API-eindpunten en onschaalbare architectuur.

Wat controleer je op een door AI ontwikkelde app?

We beoordelen de beveiliging (OWASP, Secrets, Auth), codekwaliteit en -architectuur, databasestructuur, API-ontwerp, foutafhandeling, testdekking, operabiliteit en schaalbaarheid, en stellen een geprioriteerd actieplan op.

Wat is het verschil met een normale codebeoordeling?

Onze AI-app-recensie is gespecialiseerd in de typische kwetsbaarheden van door AI gegenereerde code: beveiligingskwetsbaarheden als gevolg van een gebrek aan mondiale context, architectonische inconsistenties, kopieer-plak-redundanties en een gebrek aan operationele basisprincipes zoals testen, CI/CD en monitoring.

Hoe lang duurt een AI-codebeoordeling?

Een korte rapportage met de belangrijkste risico's is binnen 48 uur mogelijk. Een compleet rapport met architectuuranalyse en actieplan duurt afhankelijk van de scope 5-10 werkdagen.

Welke toegang heb je nodig?

Meestal repo-toegang (bijv. GitHub, GitLab), infrastructuurdocumentatie en, indien nodig, testtoegang. Bij de kick-off spreken we de omvang af en werken vertrouwelijk.

Hoeveel kost de AI App Review?

De exacte kosten zijn afhankelijk van de complexiteit en gewenste nauwkeurigheid van de rapportage. Een eerste algemene rapportage kost bij ons in de regel tussen de € 1.000,- en € 2.500,-. In een kosteloos voorgesprek verduidelijken wij de concrete kaders.

Kan ik de app verder ontwikkelen of achteraf laten stabiliseren?

Ja. Na de review kunnen wij zorgdragen voor stabilisatie, doorontwikkeling of volledige conversie, inclusief roadmap, security fixes en implementatiesprints.

Is de review ook geschikt voor een app die ik wil kopen of waarin ik wil investeren?

Ja. Onze AI-app-beoordeling biedt een technisch beslissingssjabloon voor investeerders en kopers, met duidelijke risico's, kostenimplicaties en aanbevelingen voor evaluatie.

Welke AI-tools kunt u overwegen bij een app-audit?

Wij beoordelen apps die met gangbare AI-tools zijn gebouwd: Lovable, Claude Code, ChatGPT/Codex, Cursor, GitHub Copilot, v0.dev, Replit Agent en andere. Elke tool heeft typische zwaktepatronen die we gericht meenemen in de review.

Kun je een Lovable-app laten controleren?

Ja. Leuke apps gebruiken React met Supabase-backend, een patroon dat duidelijke beveiligingsrisico's met zich meebrengt: Supabase-sleutels in de frontend-bundel, ontbrekende beveiliging op rijniveau, geen validatie aan de serverzijde en auth-logica rechtstreeks in de client. We onderzoeken precies deze zwakke punten en zorgen voor een geprioriteerd actieplan.

Kun je een Claude Code-app laten controleren?

Ja. Claude Code heeft ook typische hiaten: ontbrekende tests, geen CI/CD-opstelling, architecturale beslissingen zonder algemene context en operationele basisprincipes die geen deel uitmaakten van de prompt. We controleren onafhankelijk en laten zien wat er ontbreekt voordat er productief wordt gewerkt.

Kun je een ChatGPT/Codex-app laten controleren?

Ja. ChatGPT/Codex-apps en features ontstaan snel, maar hebben vaak gaten door ontbrekende totaalcontext: inconsistente auth, zwakke foutafhandeling, ontbrekende tests en geen duidelijke scheiding tussen ontwikkel- en productieomgeving. Wij beoordelen wat voor productie moet worden omgebouwd.

Controleert u ook apps die met meerdere AI-tools tegelijk zijn ontwikkeld?

Ja. Veel projecten ontstaan ​​met een combinatie van b.v. B. Leuk voor de frontend, Claude Code voor backend-logica en Copilot voor individuele functies. We controleren de volledige codebasis, ongeacht de gebruikte tool, inclusief inconsistenties in de interfaces.

Hoe vertrouwelijk is het rapport?

Wij werken vertrouwelijk en ondertekenen op verzoek een NDA. Resultaten en code blijven uitsluitend van jou.

Nog een vraag die hier niet wordt beantwoord? Verduidelijk in de afspraak →

Waarom CodeGuides voor de AI-app-beoordeling?

  • Intern team uit Duitsland: Je werkt met een vast Duits team: geen freelancers, geen outsourcingrisico.
  • ⌨️ Experts voor complexe projecten: U profiteert van specialisten op het gebied van architectuur, app-ontwikkeling, backend en QA, allemaal vanuit één bron.
  • 💲 Kostentransparantie & duidelijke planning: Volledige transparantie door tijdregistratie van minuut tot minuut, realistische routekaarten en betrouwbare inspanningsschattingen.
Portret van Alexander Hähnel
Alexander Hähnel
Managing Director, app- en softwareontwikkeling
Portret van Franz Opitz
Franz Opitz
Managing Director, Automatisering en Cloudimplementatie

Laat de door AI ontwikkelde app controleren: Boek een voorgesprek

Met CodeGuides

CodeGuides is een app- en AI-bureau uit Duitsland voor Flutter-apps, maatwerksoftware, AI-automatisering en lokale AI-infrastructuur. Advies en implementatie komen uit één bron: we evalueren gebruiksscenario's technisch, bouwen de eerste pilot en schalen deze op naar bedrijfsbrede werking, AVG-conform en met hosting in Duitsland.

CodeGuides GmbH · Königs Wusterhausen Op de markt sinds 2019 100+ digitale projecten 100% intern (DE) Advisering & implementatie vanuit één bron